tags: cofacts, meeting note GA: UA-98468513-3 —
20230517 會議記錄
:::info
- 所有會議記錄
- Workis: bil, mrorz
- 線上出席:nonumpa, 4000
- https://gather.town/app/z3x18KQFgZCX8MeZ/cofacts :::
CCPRIP
[Comm] Transcript
https://g0v.hackmd.io/@cofacts/rd/%2FOhGIQzoxR5eF6audQuS_FQ nonumpa
Deploy
https://github.com/cofacts/rumors-deploy/pull/24
Auth
https://tiptap.dev/hocuspocus/guides/auth
遇到 Error
[onLoadDocument] First argument to DataView constructor must be an ArrayBuffer
Packaging
https://daveiscoding.com/nodejs-typescript-monorepo-via-npm-workspaces
- tsconfig references
- https://www.typescriptlang.org/docs/handbook/project-references.html
- 但我們的 tsconfig 有三個,是要給 npm package 用的 [name=nonumpa]
- 如果 references 指到其中一個 tsconfig 說不定會 work [name=mrorz]
[Comm] LLM-aid fact checking
年份問題 https://g0v.hackmd.io/mU8qi721RZeAQ9PDfj7XRA#2023517-Year-issue
:::success 實作 :::
[Op] 分身帳號處理
https://g0v.hackmd.io/ndNDmEkiSHyTRMOEIy2q2Q (Cofacts workspace owner only)
GA4
https://g0v.hackmd.io/@cofacts/rd/%2FcJFFXVzgT4OFT6bBLtulGg
Access of open data
Huggingface dataset: https://huggingface.co/datasets/Cofacts/line-msg-fact-check-tw
命名討論
有名的 dataset 都是因為有名的 model 或是比賽才紅的 我猜大原則就是 specific/clear 如果是我的話 我會這樣取 line-msg-fact-check-110k-tw [name=Chen-Hung, Pai] dataset 可以換名字嗎之後 [name=mrorz] 上傳新的感覺更好 不知道到時候格式什麼的會不會改變 或是你100k上傳之後 會開始收到使用人給的回饋 那你可能就會在 200k 做修改 如果有人要 benchmark 那應該會(有人使用舊版) 因為現在大家也漸漸意識到資料質量比數量重要的多 我指的比較像是 資料跟前一版 有著很大程度的不同 這種 例如說有先幫他們做了很多過濾 處理 分類資料 那就比較適合另外開一個 如果單純只是數量上的增加 那在原本的應該就行了 [name=Chen-Hung, Pai] 好奇加了 100k 大家會比較想用嗎 [name=mrorz] 在意訓練資料數量的人就會想 大部分是都沒加就是了 但這通常都是有名的work或是org做的
目前問題
因為他以為每個 CSV 都一樣的結構,試圖產生 split
但我這些根本是不同結構的資料
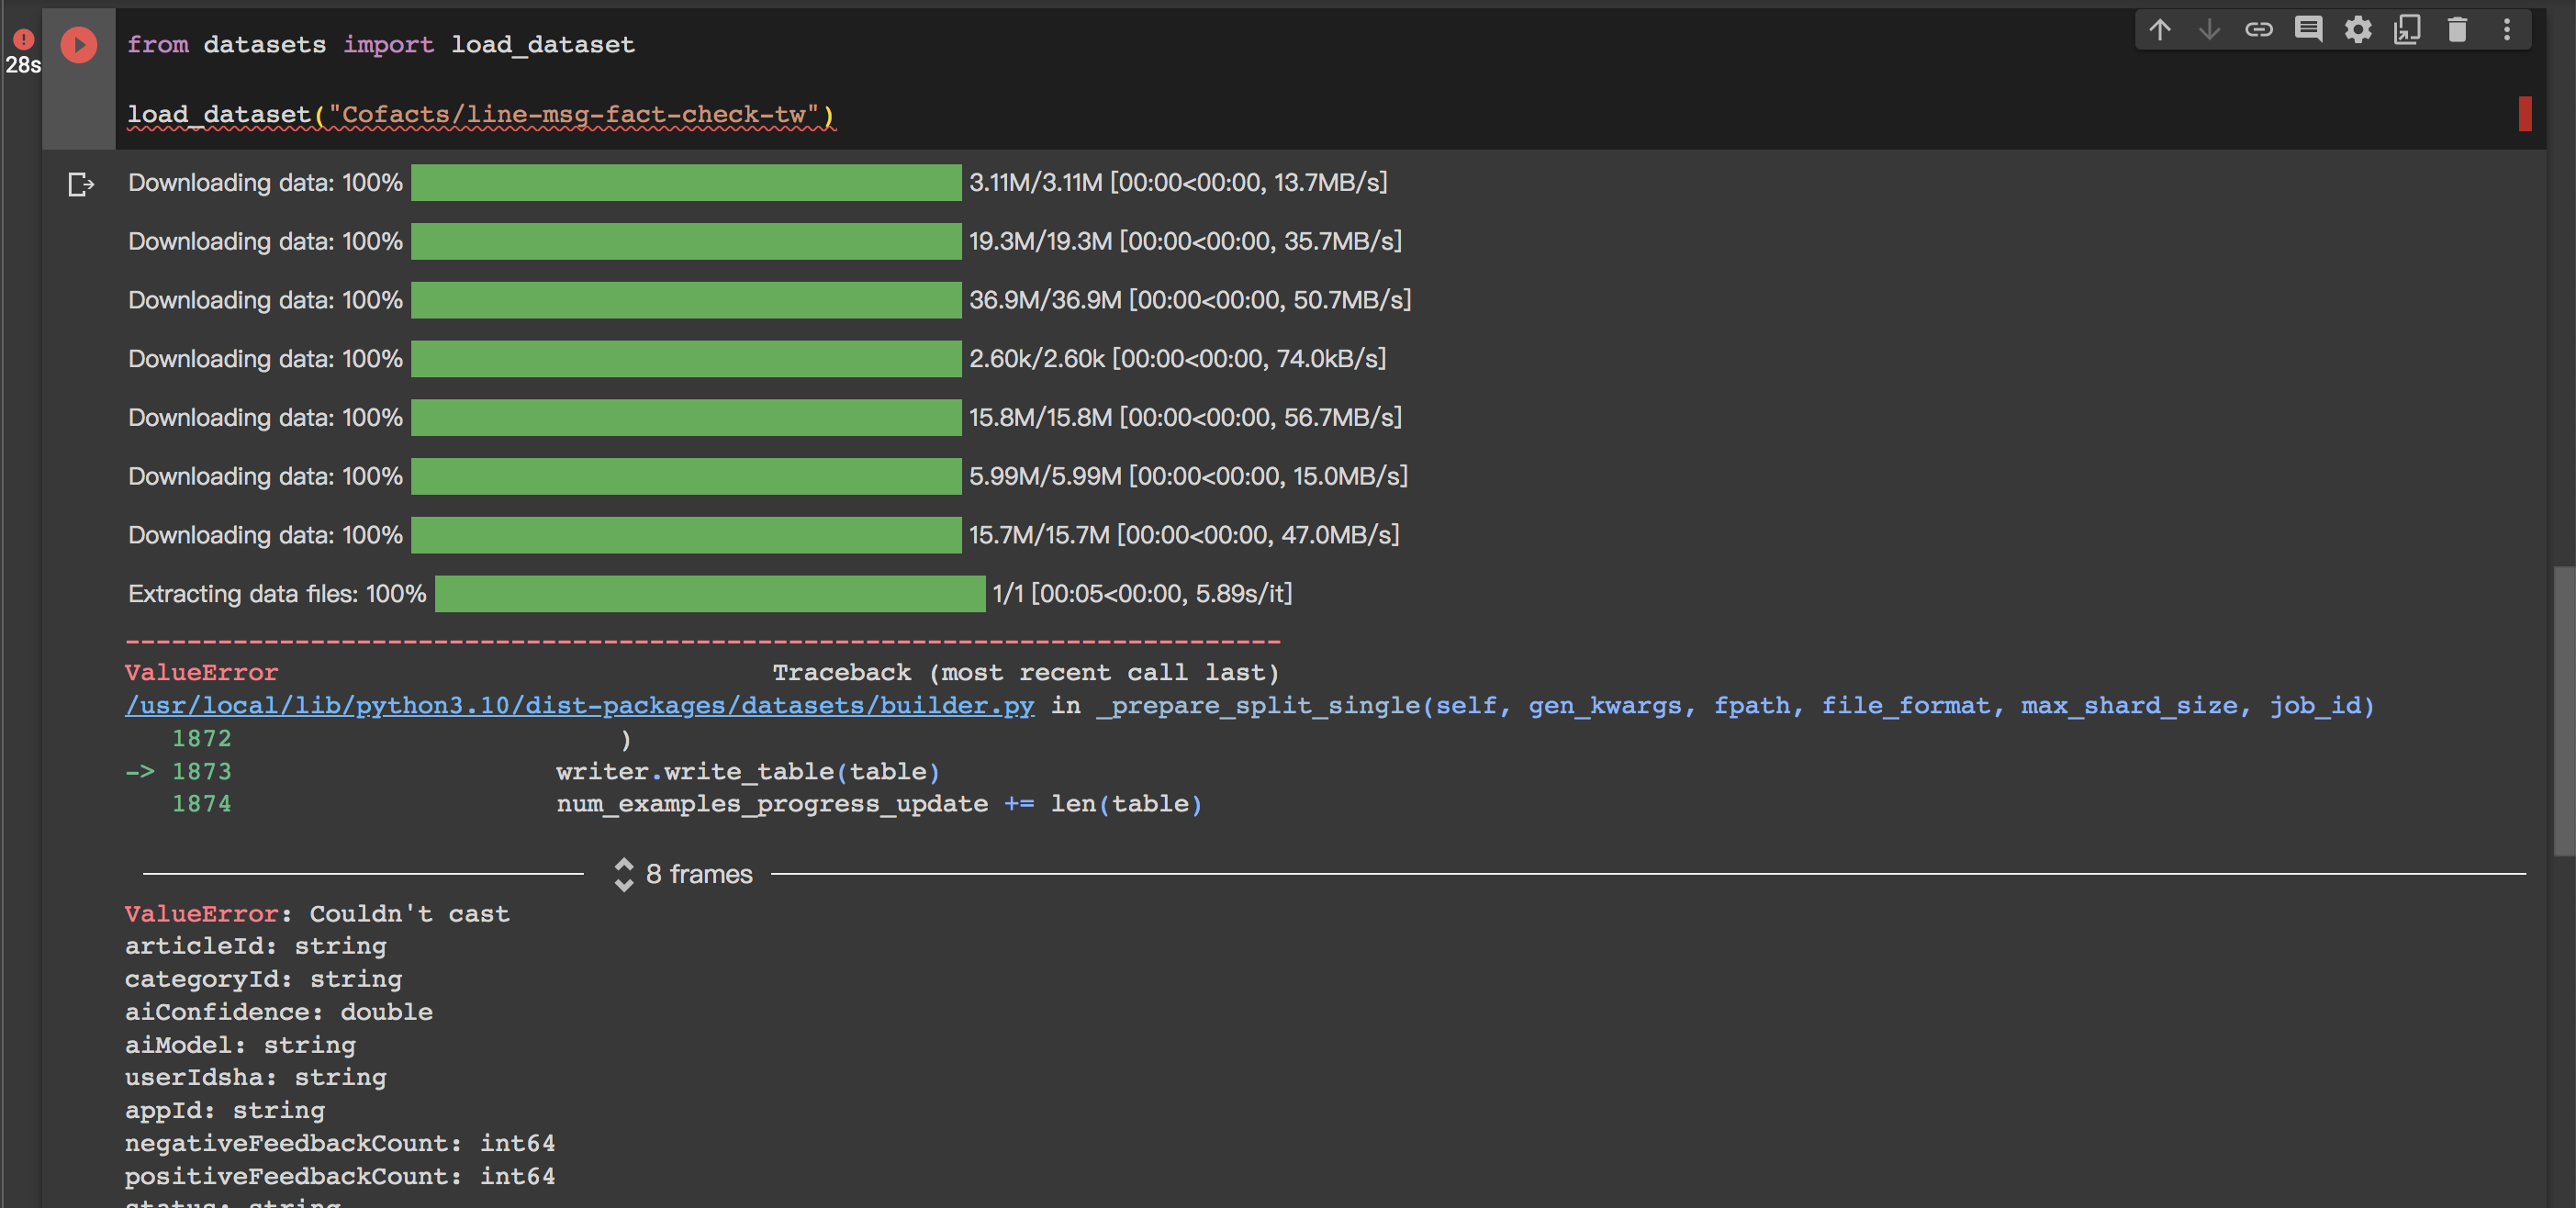
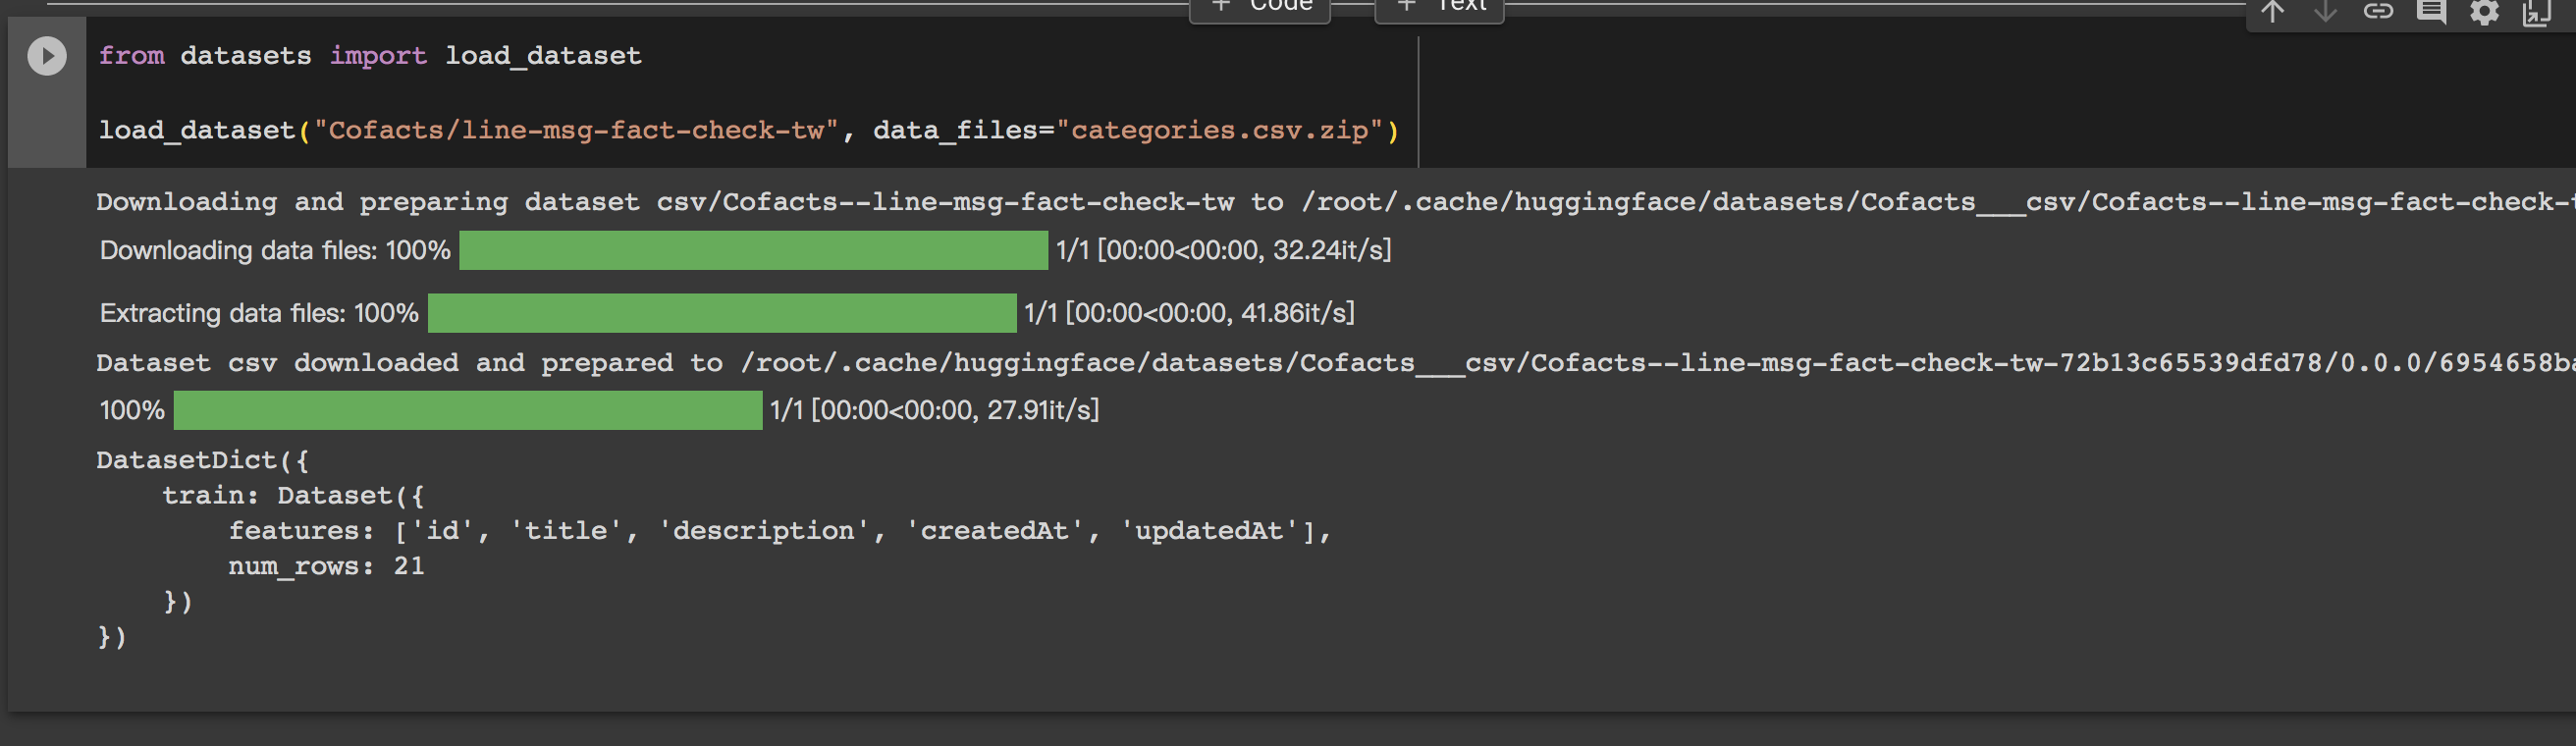
需要指定 datafiles
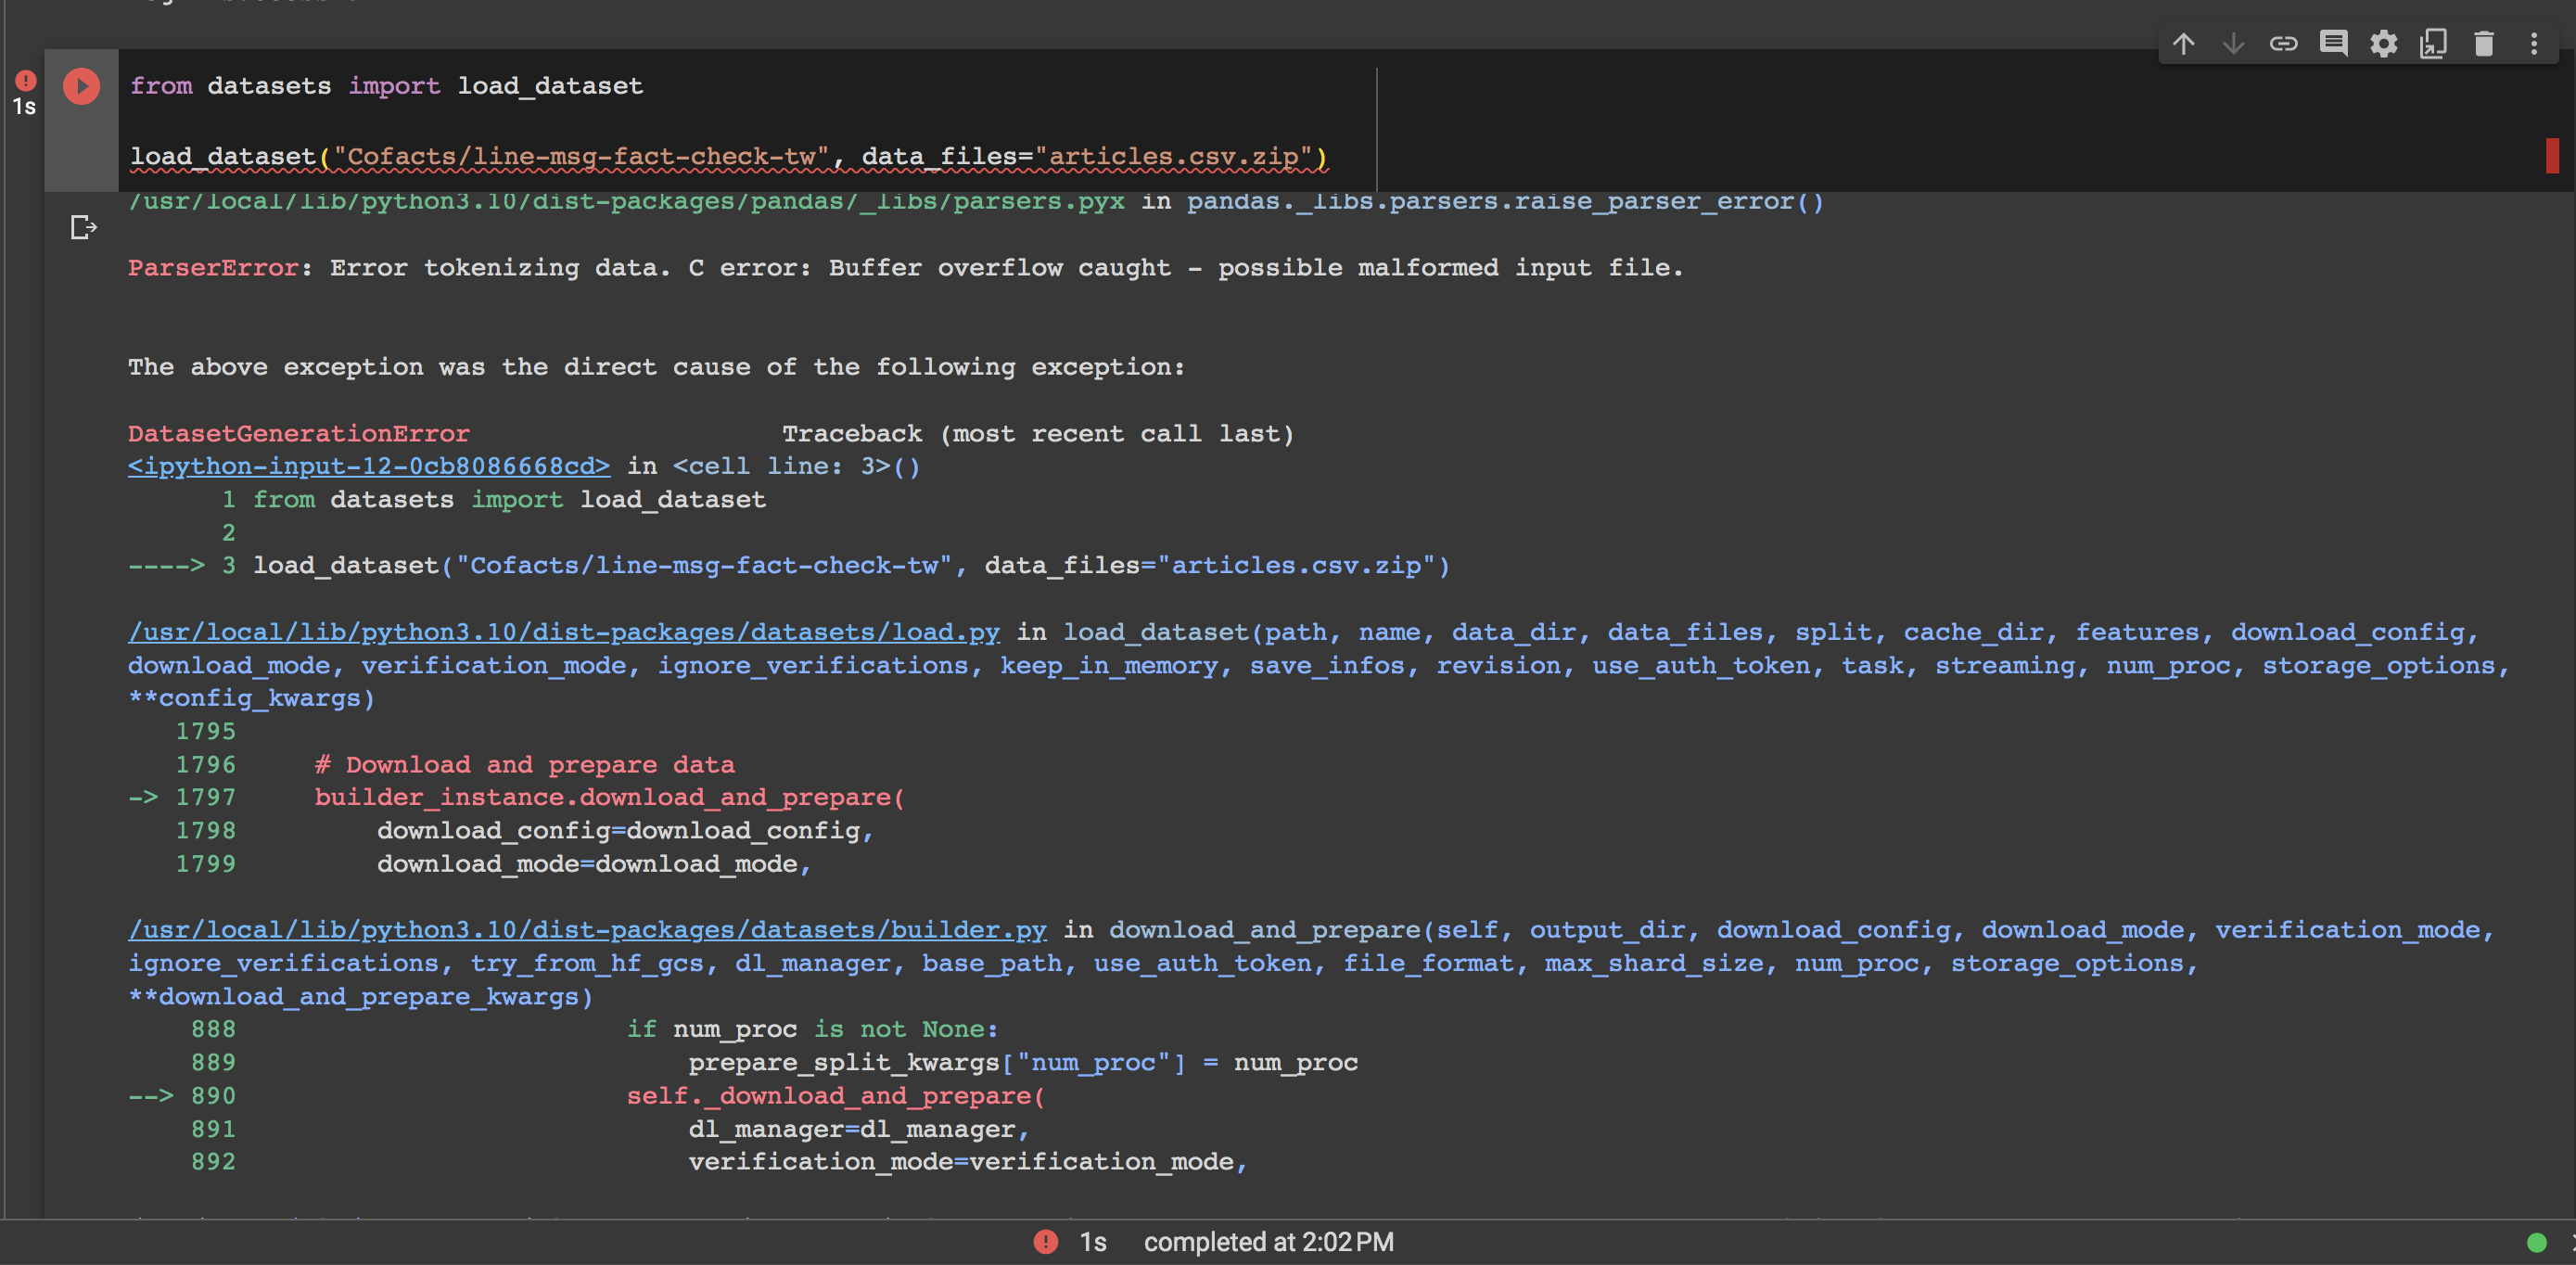
但 articles.csv 居然會讀到 buffer overflow
:::success
- 研究如何讓使用者用
- 改 README
- Optional
- 更新 cofacts/opendata README 指向到 huggingface
- 資料使用者條款:更新 open data URL
- 請註冊 huggingface 帳號來加 organization :::
小聚籌備
- 地點:
- 2023/5/27 2pm - 5pm
- 台南新芽
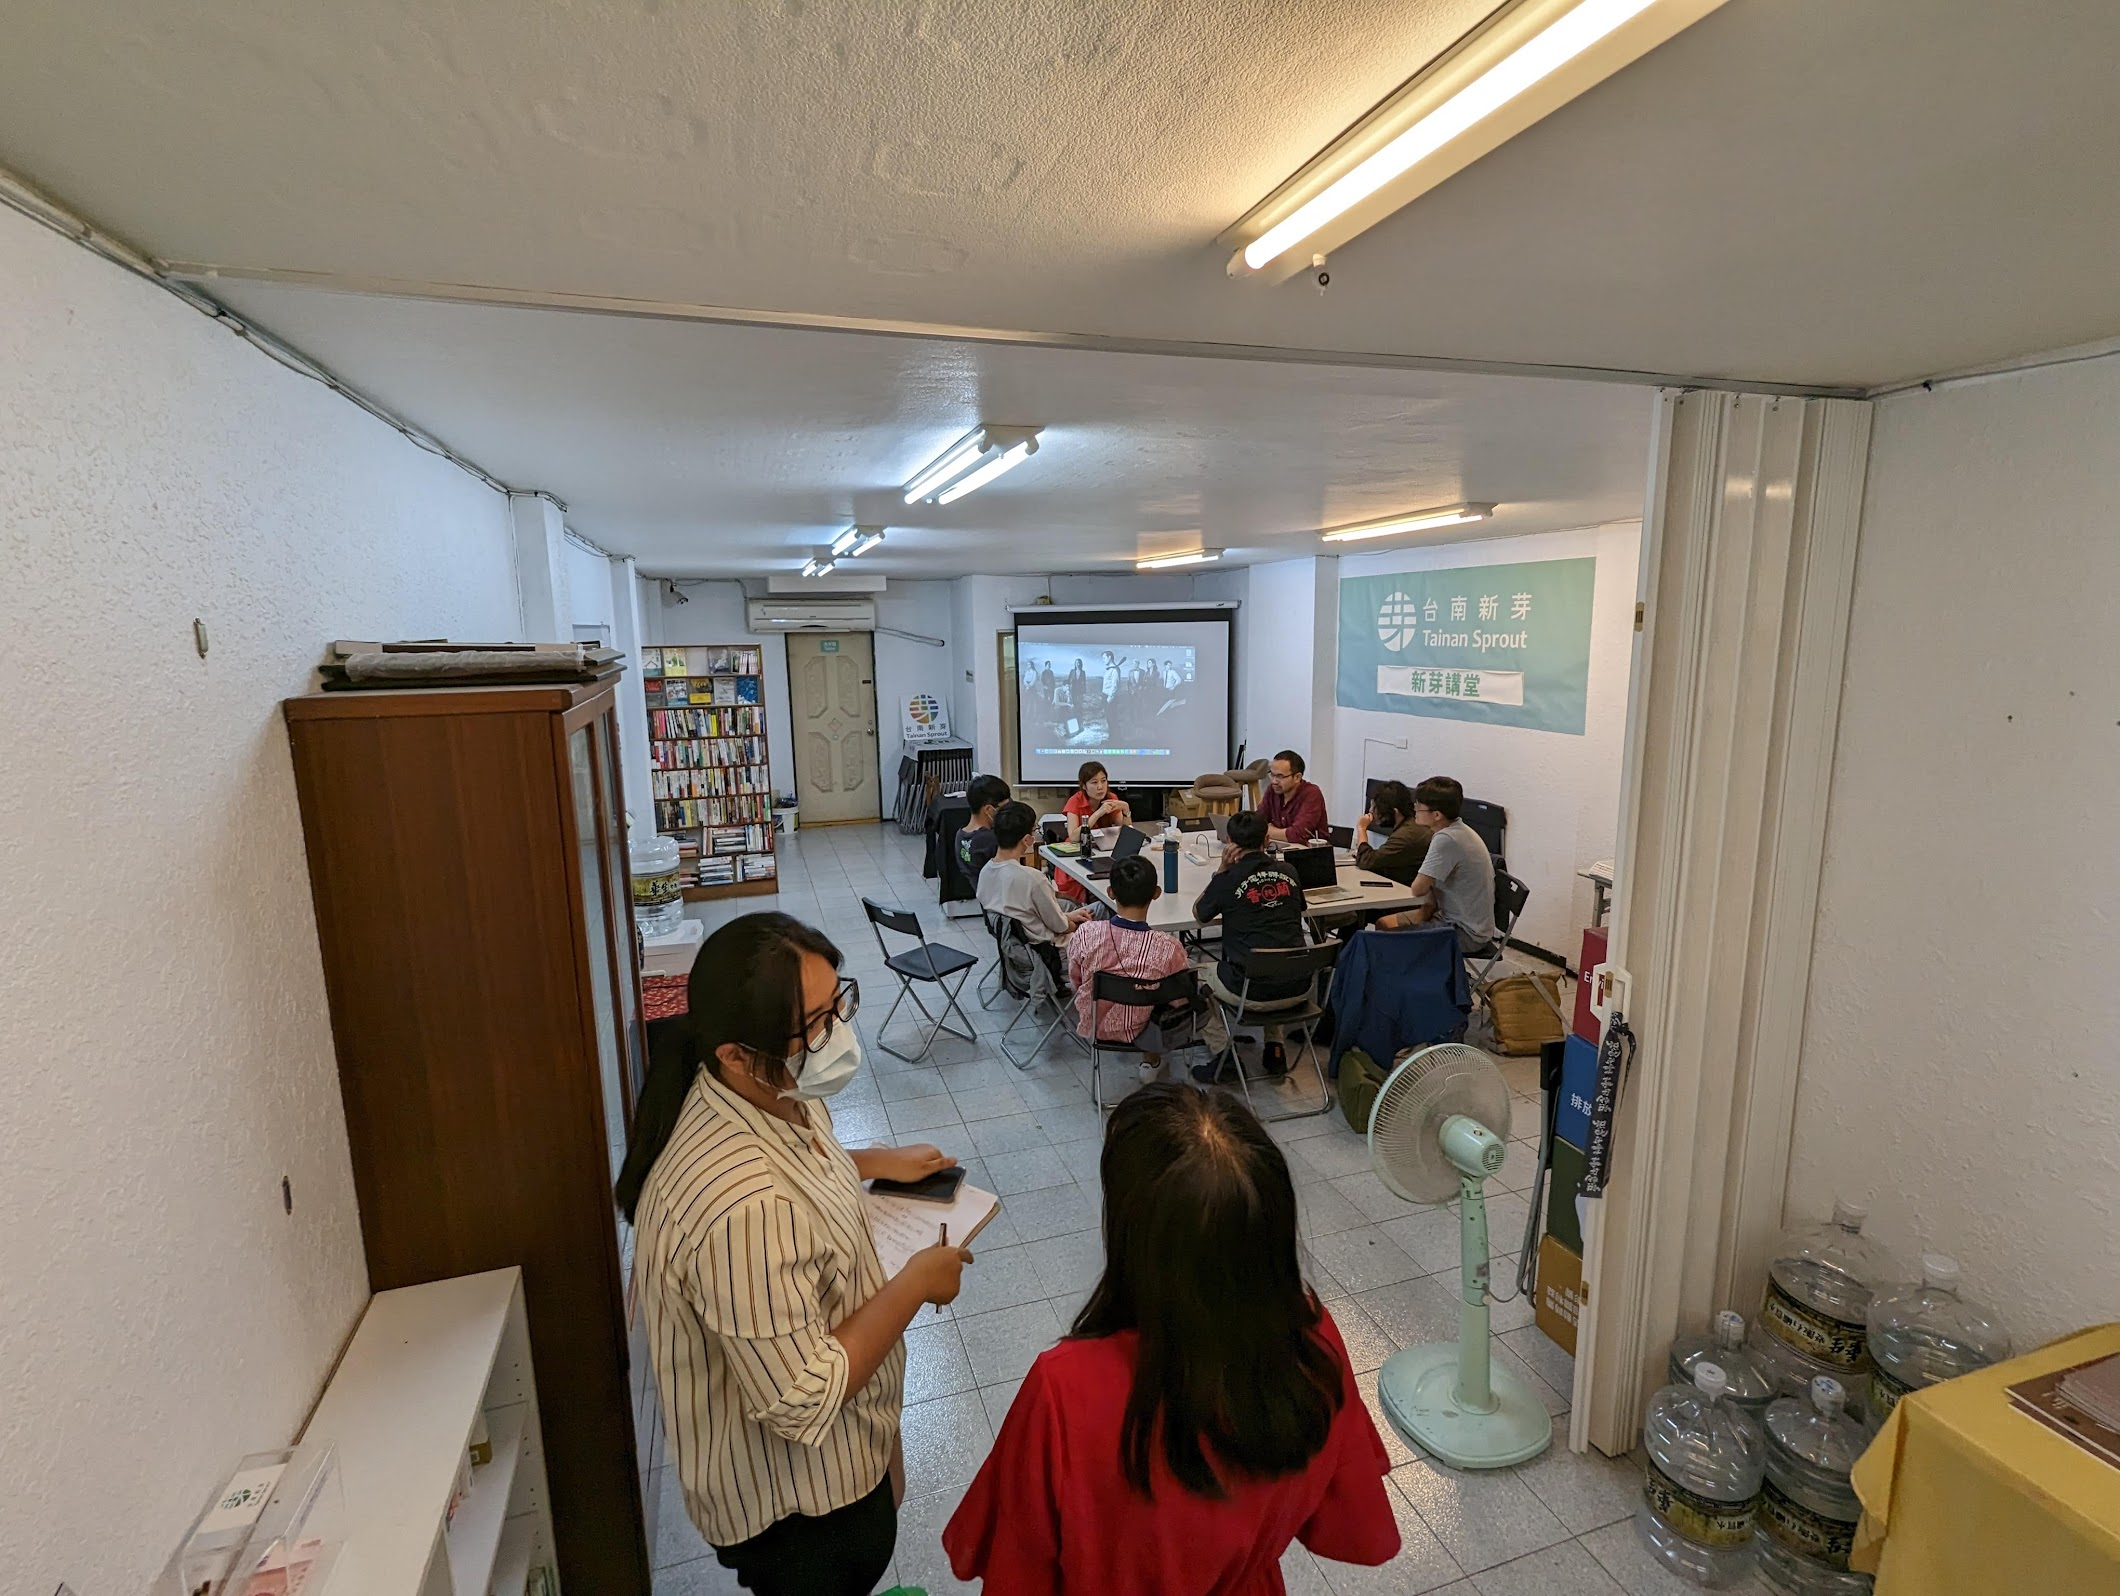 三張大桌子,坐15人以內舒適,有延長線跟飲水機和廁所,開門即會場。當天會有新芽工作人員陪伴
- 食物?統編?
- Maybe 双生綠豆沙?
- 場地費:轉帳新芽
- 時間:
- 活動時間:14:00 - 17:00
- 時間分配
- 2:00 - 2:20 開場
- 影片
- Slido 暖身
- 2:20 - 2:40 引導註冊網站、介紹評價現有回應
- 2:40 - 2:50 實作評價
- 2:50 - 3:10 介紹補充資訊
- 3:10 - 3:40 實作補充資訊、自我介紹、休息
- 3:40 - 4:10 介紹撰寫新回應
- 4:10 - 4:40 實作撰寫新回應
- 4:40 - 5:00 介紹分類、RSS、合照
- 2:00 - 2:20 開場
- 投放目標:台南、高雄、嘉義 57,000 人
- KKTIX:https://cofacts.kktix.cc/events/cofactseditor37
- 誰會來呢:bil, mrorz, nonumpa
- bil要記得帶的:杯子、貼紙、粉粉文宣
- 需使用實體車票
- LINE 文案: 「台南市被列入全台10大疫情危險縣市?」假的!!中央流行疫情指揮中心並沒有列出10大疫情危險縣市。 活動不該只辦在台北,Cofacts 真的假的要到台南舉辦志工培訓活動啦!!5月27日(六)14:00-17:00 歡迎沒有經驗的你,用一個下午的時間當鍵盤志工,一起對抗假新聞!請自備水杯、筆記型電腦與充電線唷! 台南新芽地址:台南市中西區成功路29號4樓(賀聲助聽器樓上,一樓有電梯)
:potable_water: Release pipeline
:rocket: Staging
:robot_face: rumors-line-bot
- bigquery integration https://github.com/cofacts/rumors-line-bot/pull/351
Testing checklist
https://lin.ee/1QUzEX4nI
- 隨便點點,沒壞掉
Found Issue
- Group / Join / 1 (Event category / Event action / Event value) 沒有送 event