tags: cofacts, meeting note GA: UA-98468513-3 —
20220216 會議記錄
:::info
- 所有會議記錄
- Workis: bil, mrorz, nonumpa
- 線上出席:kukka, cai, 4000
- https://gather.town/app/z3x18KQFgZCX8MeZ/cofacts :::
圖片 Hash 效果與搜尋
Hash length
bits=12 –> 144 bits hash –> 24 characters in Base64 / 36 characters in Hex
bits=16 –> 256 bits hash –> 44 characters in Base64 / 64 characters in Hex
Indexing
Given hash (binary vector),下面有些 hamming space 裡做搜尋的方式。
應屬於 Nearest neighbor (NN) & Approximate NN (ANN) search 右下角的 Hamming-based solution。
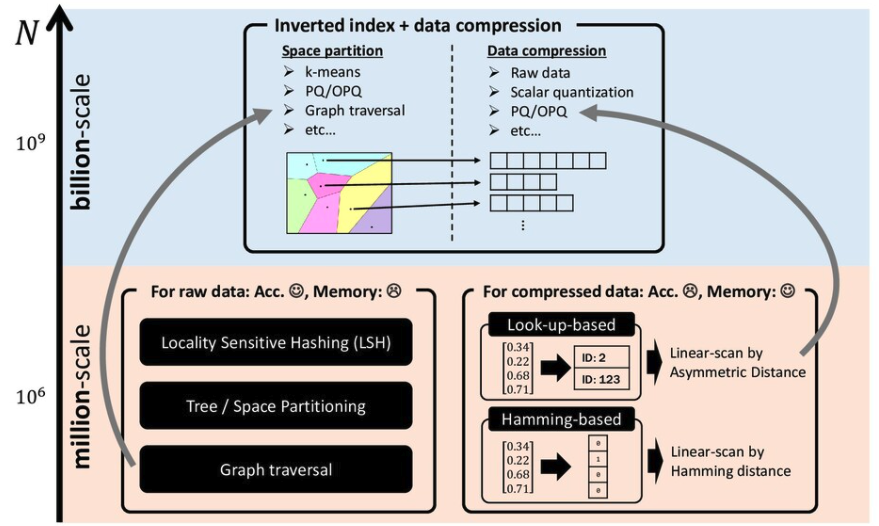
- 資料結構 https://stackoverflow.com/questions/6389841/efficiently-find-binary-strings-with-low-hamming-distance-in-large-set
- HmSearch (2013)
- Paper - https://citeseerx.ist.psu.edu/viewdoc/download?doi=10.1.1.353.1266&rep=rep1&type=pdf
- JS lib - https://github.com/commonsmachinery/hmsearch-node
- Multi-Index Hashing (2012)
- C++ https://github.com/norouzi/mih
- GPH (2018) https://jqin.gitee.io/files/icde2018-qin.pdf
- Summary of above techniques (2021) https://szudseg.github.io/kdd21-tutorial-high-dim-simqp/
- 在 Elasticsearch 做 exact NN search on Hamming space (2019): Fast and Exact Nearest Neighbor Search in Hamming Space on Full-Text Search Engines
- 原理
- 用 painless 實作一個算 64bit 的 hamming distance 的 script
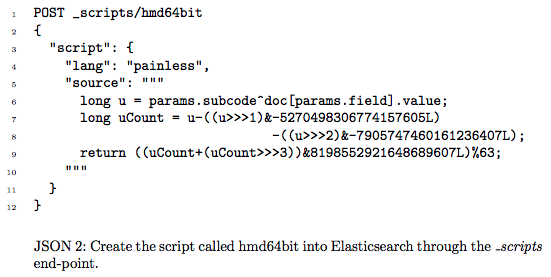
m-bit binary code 可以被切成s個 sub-code (每段小於等於 64 bits)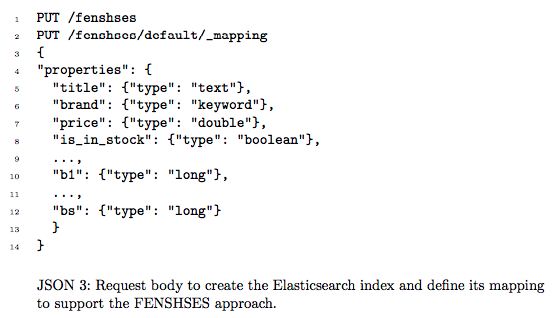
- 我們可以把 256-bit hash,每 64 bit 切成一個 subcode,只需 4 個 subcode。
- 找出跟
q的 hamming distance 小於r的 vector,就是把q的那s個 sub-code,與資料庫裡的 vector 的s個 sub-code 拿去算 hamming distance 加總 - 根據鴿籠原理,如果
q跟資料庫裡的 codeb的 hamming distance <r,那它們的 subcode 們至少有一對的距離會小於 $\lfloor\frac{r}{s}\rfloor$。用這個原理進行 sub-code filtering 可以減少實際需要計算 hamming distance 加總的數量。
- 用 painless 實作一個算 64bit 的 hamming distance 的 script
- 範例 query, 給定
q的 subcodeq1~qs: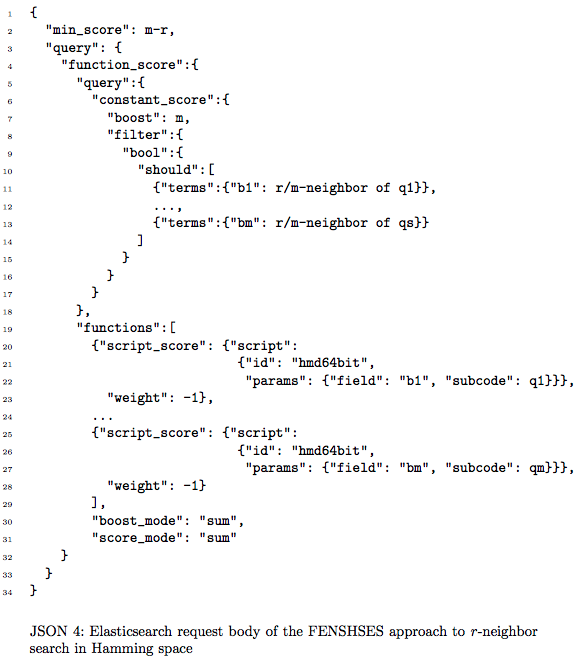
- L5 的
query是 sub-code filtering- Elasticsearch
termsquery 是窮舉,數量有上限b1~bm用keyword會不會比用long好?https://www.elastic.co/guide/en/elasticsearch/reference/7.16/number.html
r/m-neighbor of qs: 假設 qs =00000000(8-bit sub-code), 那 3-neighbor ofqs應該就是所有包含 0~3 個 1 的 code,有 $1+C^8_1+C^8_2+C^8_3=93$ 個- 假設 qs 是 64 bit sub-code, r = 10, m = 256/64 = 4, 那 r/m = 2.5。算 2 的話,2-neighbor 就有 $1+C^{64}_1 + C^{64}_2=2080$ 個。
- Elasticsearch
- L19 的
functions是實際算 hamming distance 用來排序的。 - L2 的
min_score把距離 cut-off 在r m跟s差在哪我搞不懂 [name=mrorz]
- L5 的
- Running demo (包成 container ㄌ) https://github.com/gyang274/visual-search
- 裡面用 binary hash 是用中研院的 Semantics-Preserving Deep Hashing (SSDH)
- 原理
- Elasticsearch Fuzzy Query
- 算 Levenshtein edit distance
- 距離最多只有 2
遮除電話
https://cofacts.tw/article/5661460621638-rumor
應考慮以下需求:
- Google 「立法委員手機號碼」後,不會有此頁面,或者是進到此頁面但無法打電話
- 真的假的 LINE bot 使用者將此訊息傳入之後,不要讓使用者再送一份新的進來
- 若無法達成,就未來送進來時再處理一次
以下為 staging 測試結果。
原文
用一樣的網傳訊息搜尋,得到 100% 相似度
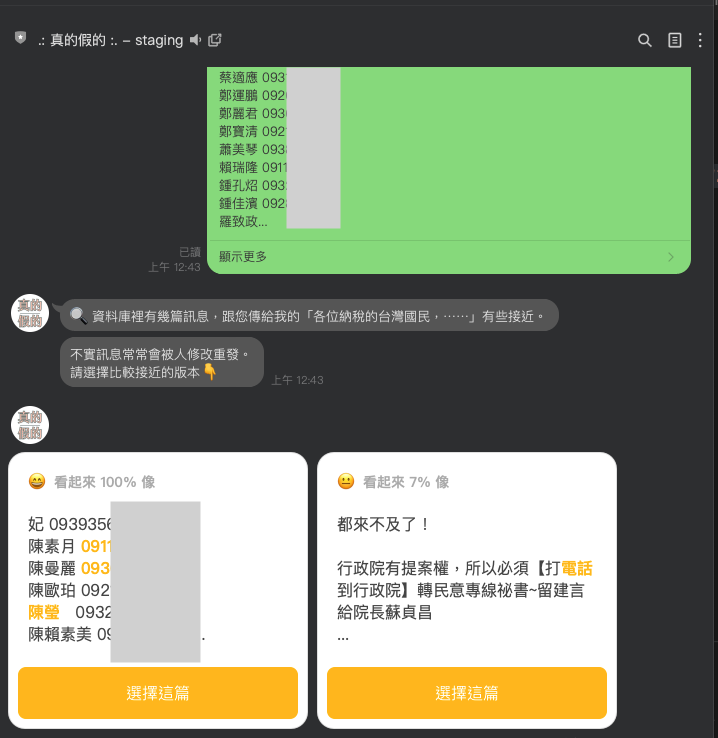
看起來 more_like_this query 會選擇電話作為重要關鍵字
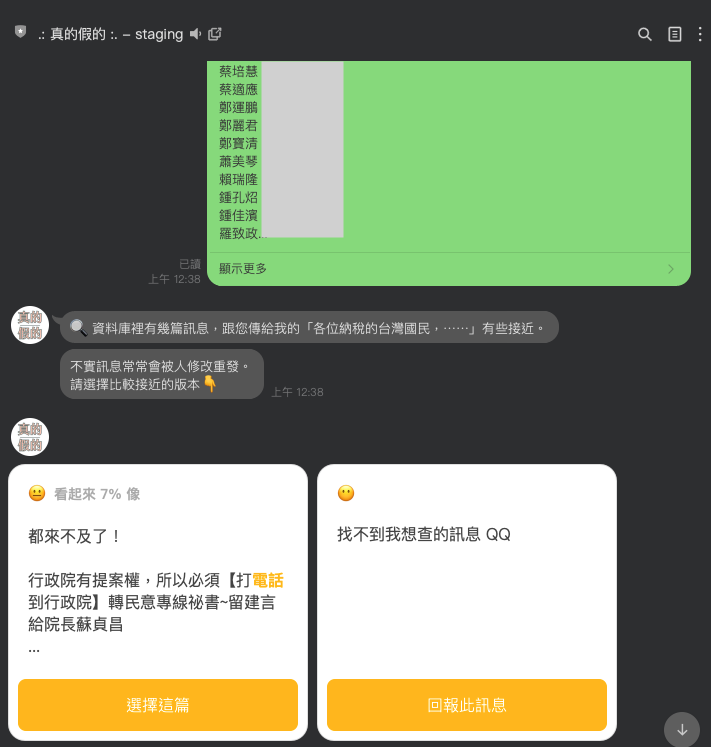
用「X」遮除中間三碼、或刪掉所有號碼留下名字
chatbot 用完整帶電話的訊息來搜尋,就完全找不到原文了
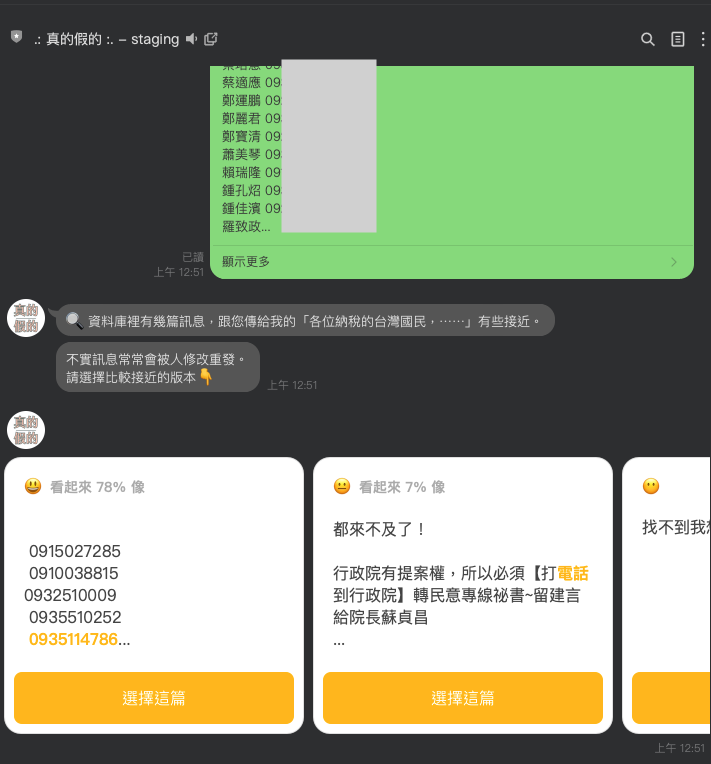
只刪掉名字
結果:78% 像
只留下第一段文字
結果:找不到
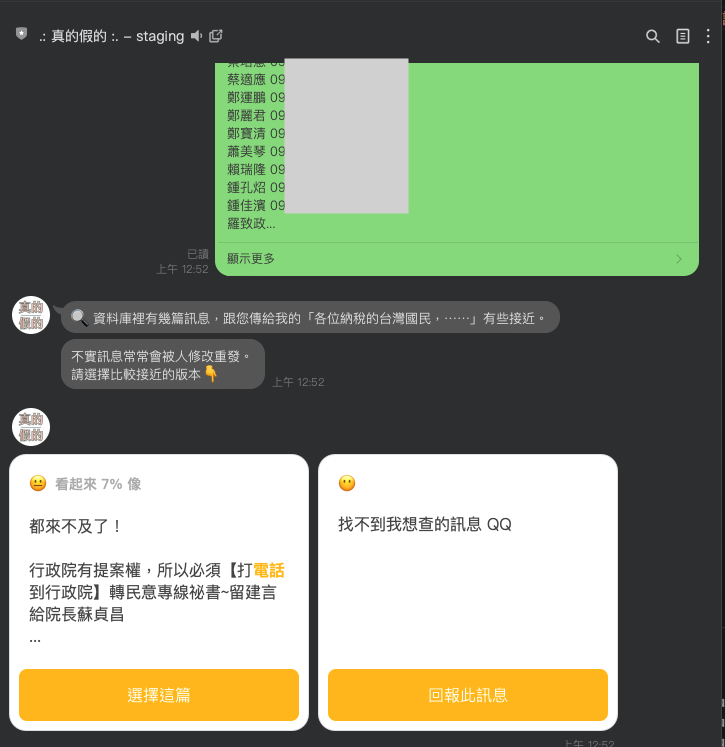
討論
- 即使是「只刪掉名字」的 solution,78% 的相似度還是不夠高,LINE 使用者仍可能會選擇「找不到我想查的」然後把此隱私訊息送進資料庫。 [name=mrorz]
- 因此,看起來「真的假的 LINE bot 使用者將此訊息傳入之後,不要讓使用者再送一份新的進來」應是無法達成之事。
- 名字跟電話拿掉,因為電話的次序還在的話,還是對得到是誰 [name=bil]
- 如果 LINE 使用者送「完全一樣」的訊息進資料庫,會因為 article ID 相同,而不會產生新的文章 [name=nonumpa]
- 不過如果差個空白,就會被算成另一篇了,會需要另外處理 [name=orz]
- 可以讓他找得到但不顯示嗎 [name=bil]
- 這就要看 elasticsearch 是不是能讓 index 的值跟印出來的值分開的東西了 [name=orz]
:::success 結論:
- 先把名字與電話通通拿掉
- 如果有 LINE 使用者再成功送進來,就再手動處理
takedown notice 內文提及?
- 立委辦公室成員反應
- 原需求:Google 「立法委員手機號碼」就會有隱私
考量
- 手機為個人隱私
- 陳情應使用公開管道(過往社群專案亦如是)
執行 by mrorz
- 「只留下第一段文字」的版本
- 「我想補充」處留下 takedown announcement link :::
大松籌備
- 線上大松
- 誰會到: bil, mrorz (提案)
- Good first issue
- 檢討: 小精靈放音樂、投影 community builder
- 整點 ~ 10 分是休息時間
- 程式 = 網站的 good first issue https://github.com/cofacts/rumors-site/issues?q=is%3Aissue+is%3Aopen+label%3A%22good+first+issue%22
小聚籌備
- 場地借到了 NPO hub 2F